一个文字节点如何撑起四个结局:互动影游降低视频成本的混合媒介设计
用视频、文字、静帧、聊天和语音组合四个结局,在保留互动后果的同时控制制作成本。
开篇导读
全视频并不天然更沉浸。证据阅读、内心判断、手机聊天和跨时段变化如果都拍成视频,成本更高、信息更难回看、修改也更慢。混合媒介的原则是:视频负责必须看见的表演与动作,文字负责需要比较、回忆和快速迭代的信息。
一个节点怎样支持四个结局
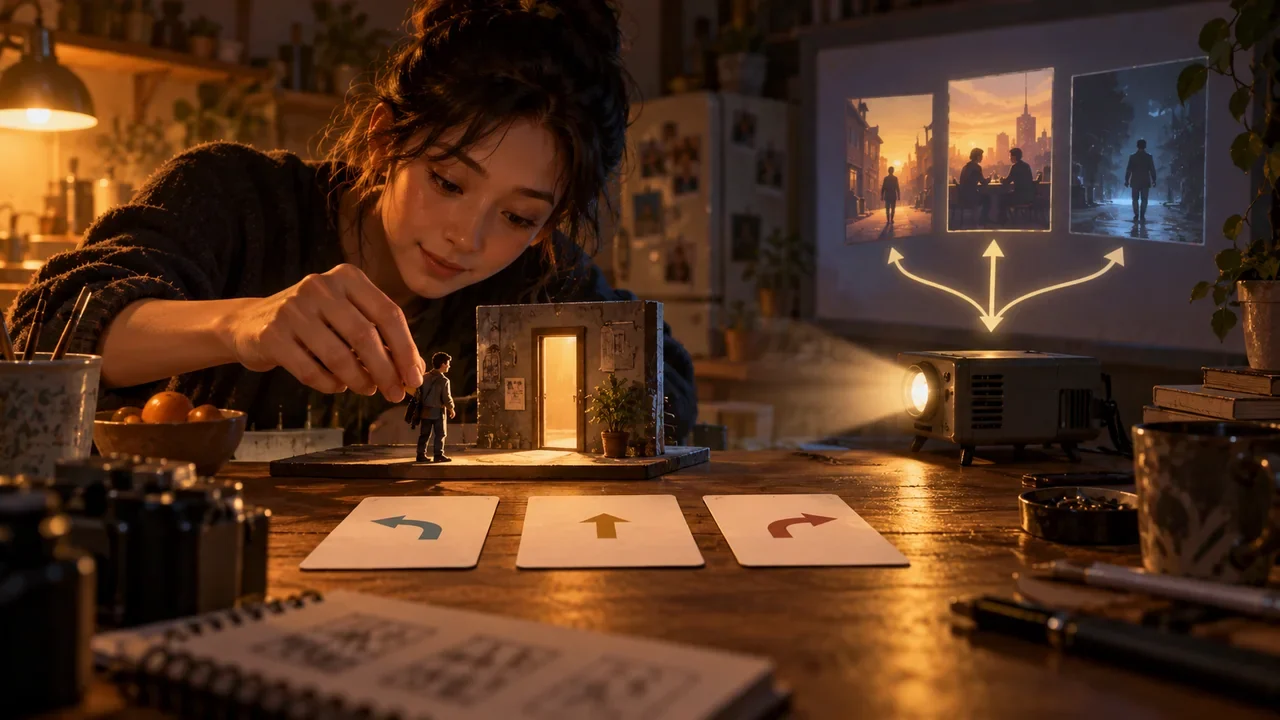
假设主角在最终对峙前收到一段聊天记录。文字节点展示三条已掌握证据,并让玩家选择“公开全部”“只给盟友”“删除记录”或“伪装不知”。这个动作写入 evidence_action,最终视频仍可复用同一个会场与开场表演,再通过不同的手机画面、两句对白和结局旁白兑现四种状态。
四个结局不必拍四部完整短片。最昂贵的视频承担共同高潮,状态差异通过可替换短镜头、文字、声音和尾声组合呈现。
不同媒介最适合什么
| 媒介 | 适合 | 不适合 |
|---|---|---|
| 视频 | 表情、动作、危险、关系破裂 | 大段可检索信息 |
| 文字 | 证据、内心、摘要、规则 | 依赖身体表演的高潮 |
| 静帧 | 地点建立、档案、回忆 | 连续复杂动作 |
| 聊天界面 | 时间线、关系与异步冲突 | 每场戏都替代面对面对话 |
| 语音 | 私密信息、画外空间 | 无字幕的关键证据 |
混合节点如何转场
进入文字前,用角色动作给出物理来源,例如拿起手机或展开文件;退出时,让下一段视频从同一物件与身体状态开始。媒介切换有叙事原因,就不会像加载页。
一份预算分配样例
对于 10 分钟单次体验,可把约 70% 独立资产时长留给共同视频主干,15% 给关键分支视频,15% 给文字、静帧、聊天和尾声变体。比例只是规划示例,应按表演价值与工具成本调整,不能当行业报价。
什么时候文字不是节省,而是增强
玩家需要停下来比对证据、回看名字、思考承诺时,文字比连续影像更有控制感。它还能支持字号、朗读和多语言适配。混合媒介的目标不是“便宜地凑结局”,而是让每种内容用最适合被理解的形式出现。
四个结局怎样由状态组合产生
把 evidence_action 与前一章的 ally_trust 组合,而不是让最后一个按钮单独决定全部结果。公开全部且盟友信任高,可以得到共同作证;公开全部但信任低,对方可能否认来源;只给盟友则换来私下交易;删除记录进入信息缺失结局。四个结果来自可追溯状态,而非四段随机尾声。
设计表要为每个结局列出前置、触发镜头、必须新增的媒体和可以复用的部分。共同会场视频负责空间、表演和危机,手机特写显示证据处理,两句可替换对白读取关系,最后的静帧或声音交代长期后果。这样可以估算真实资产,而不是只数结局标题。
媒介切换必须有叙事理由
从视频进入文字时,先展示角色拿起手机、翻开档案或停下来回忆;返回视频时保持人物位置、手中物件和时间连续。若界面突然出现一大段说明,玩家会把它理解为预算不足的加载页。转场本身要告诉用户为什么现在适合阅读或操作。
文字节点同样需要演出:信息层级、逐条出现、声音反馈和选择后的状态变化都能维持节奏。但关键证据必须允许暂停和重看,不能为了“电影感”强制快速消失。
混合媒介的验收清单
测试者应能说出每次切换的来源、读懂全部关键信息、在最大字体和屏幕阅读器下完成选择,并从结局追溯此前状态。再分别统计视频制作、文字编辑、本地化和 QA 工时,确认节省的视频预算没有被复杂界面与组合测试吞掉。
当一个情绪只能通过演员的停顿和身体动作成立,就不要用文字省掉;当一项信息需要反复比较,就不要强迫用户从视频里记住。成本控制应服从理解与情感,而不是反过来。
先做无美术原型
用占位视频、纯文字和临时声音跑完四种状态组合,验证结局可达、信息可读和转场理由,再投入生成或拍摄。若原型阶段已经分不清四个结果,高质量画面只会掩盖结构问题,不能修复它。
资产完成后再次测试字幕、朗读、暂停、返回和存档。媒介越多,越要确保同一关键证据不会因某种输入方式或辅助设置而丢失。