닮은 두 캐릭터, 의상·행동·호칭으로 플레이어가 구분하게 하려면?
먼저 결론부터: 식별을 서로 독립적인 네 가지 단서로 나누고, 각 단서가 단독으로 성립하면 플레이어는 얼굴형에 의존할 필요가 없다. 네 가지는 실루엣(멀리서도 다름), 소지품(가까이서 소속감), 행동 습관(움직이면 확인 가능), 호칭과 자칭(대사에서 지목 가능)이다. 아래에서는 가상의 쌍둥이 시계공 한 쌍으로 전체 구조를 구성하며, 인물·숫자·대사는 모두 교육용 예시이지 실측 자료가 아니다.
들어가며
먼저 결론부터: 식별을 서로 독립적인 네 가지 단서로 나누고, 각 단서가 단독으로 성립하면 플레이어는 얼굴형에 의존할 필요가 없다. 네 가지는 실루엣(멀리서도 다름), 소지품(가까이서 소속감), 행동 습관(움직이면 확인 가능), 호칭과 자칭(대사에서 지목 가능)이다. 아래에서는 가상의 쌍둥이 시계공 한 쌍으로 전체 구조를 구성하며, 인물·숫자·대사는 모두 교육용 예시이지 실측 자료가 아니다.
먼저 식별표를 만들고, 그다음 콘티를 쓴다
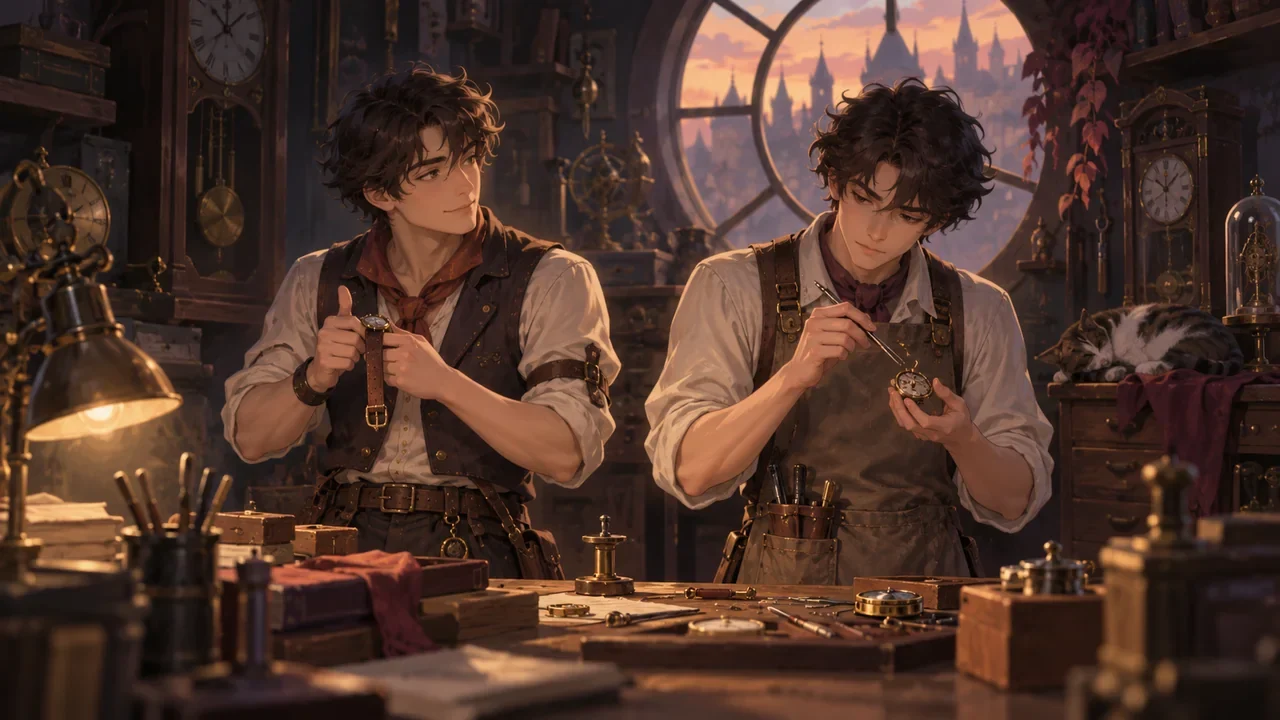
설정: 성인 쌍둥이 시계공, 형은 치윈, 동생은 치랑. 두 사람의 이목구비는 비슷하며, 이는 전제이고 얼굴로 해결할 생각은 없다.
| 단서 | 치윈 | 치랑 | 어느 층에서 확인 |
|---|---|---|---|
| 실루엣 | 긴 작업 앞치마, 밑단은 종아리까지, 어깨끈은 등에서 교차 | 짧은 조끼, 소매는 팔꿈치까지 걷어 올림, 허리에 가죽 롤 파우치 | 원경, 뒷모습, 문틀 안 |
| 소지품 | 왼쪽 가슴 주머니에 가는 핀셋 세 자루, 드러난 길이가 각각 다름 | 오른쪽 손목에 낡은 시계줄 한 바퀴, 버클은 바깥쪽 | 중근경, 손 클로즈업 |
| 행동 습관 | 말하기 전에 핀셋을 주머니에서 꺼냈다가 다시 꽂음 | 남의 말을 들을 때 엄지로 시계줄 버클을 문지름 | 대화 중, 멈춤 지점 |
| 호칭과 자칭 | 자칭 "나", 동생을 "아랑"이라 부름 | 자칭 "나", 형을 "윈 형"이라 부름 | 대사, 내레이션, 타인의 전언 |
이 표의 역할은 분업이지 중첩이 아니다. 원경은 실루엣만, 중경은 소지품, 대화는 행동과 호칭을 준다. 어느 한 층만 등장해도 플레이어는 인물을 알아볼 수 있다.
네 가지 단서 각각의 쓰기
실루엣은 한 붓으로 그릴 수 있어야 한다. 앞치마와 짧은 조끼는 어깨선, 밑단 길이, 허리 부피에서 모두 다르므로 역광이나 초점 흐림에서도 구분된다. 두 사람 모두 "어두운 작업복"을 입히는 것은 피하라. 그건 식별 부담을 다시 얼굴로 떠넘기는 것이다.
소지품은 위치와 상태를 고정해야 한다. 핀셋은 항상 왼쪽 가슴 주머니, 시계줄은 항상 오른쪽 손목; 이 장면에서 주머니, 다음 장면에서 손에 있으면 안 된다. 위치가 흔들리면 단서는失效한다. 소지품의 내력은 설명할 필요 없다, 서사에서 쓸 게 아니라면.
행동 습관은 대화 리듬에 묶어야 하고, 무작위로 끼워 넣으면 안 된다. 치윈의 "핀셋 꺼냈다 다시 꽂기"는 그가 대답을 준비하기 전에; 치랑의 "버클 문지르기"는 그가 상대의 말을 다 들은 뒤에. 이렇게 하면 행동 자체가 "누가 말하고, 누가 듣는가"의 정보를 담는다.
호칭과 자칭은 가장 비용이 적게 드는 단서다. 두 사람이 서로를 부르게 하면 플레이어는 즉시 매핑을 구축한다. 두 사람의 자칭까지 다른 별명으로 쓰지 않도록 주의하라. 그러면 외워야 할 규칙이 한 세트 더 늘어난다; 자칭은 통일해서 "나"를 쓰고, 구분은 "상대를 어떻게 부르는가"에 두는 편이 더 가볍다.
이름 없는 대사 세 토막 테스트
테스트 방법: 다음 대사에서 이름을 전부 지우고, 동작 지시와 호칭만 남겨서 화자를 지목할 수 있는지 본다. 각 토막은 먼저 단서를 주고, 그다음 독자가 추론하게 한다.
첫 번째 토막(동작만)
(핀셋을 꺼냈다가 다시 주머니에 꽂으며) 이 밸런스 휠이 틀어졌어. (엄지로 손목의 시계줄을 문지르며) 얼마나 틀어졌는데? (다시 핀셋을 꺼냈다 꽂으며) 반 칸. 네 손에 든 건? (버클을 문지르며) 같아.
추론: 먼저 핀셋을 꺼낸 쪽은 치윈, 시계줄을 문지른 쪽은 치랑. 두 동작이 각각 두 번 나와 안정적인 리듬을 이룬다.
두 번째 토막(호칭만)
아랑, 헤어스프링 핀셋 좀 줘. 윈 형, 네 왼쪽에 있어. 내 왼쪽에 있는 건 네 가죽 롤 파우치야. 그럼 파우치 뒤에 있어.
추론: "아랑"이라 부른 쪽은 치윈, "윈 형"이라 부른 쪽은 치랑. 이 토막은 외모와 동작에 전혀 의존하지 않는다.
세 번째 토막(혼합, 한 번의 오도 포함)
(짧은 조끼, 소매는 팔꿈치까지 걷어 올림) 오늘은 일 안 받아. (긴 앞치마, 어깨끈은 등에서 교차) 월세는 계속 나가. (엄지로 시계줄을 문지르며) 그래서 내 시계를 분해하고 있는 거야. (핀셋을 꺼냈다 다시 꽂으며) 분해한 거 다시 조립할 수 있어?
추론: 짧은 조끼, 시계줄 문지르기는 치랑; 긴 앞치마, 핀셋 꺼내기는 치윈. 세 번째 문장의 "내 시계를 분해하고 있다"는 치랑이 그 자리에서 한 말이며, 사실 여부는 별도로 확인해야 한다. 이 문장을 화자 식별에 쓸 수는 있지만, 그가 분해할 시계를 실제로 가지고 있다고 단정할 수 없고, 근거 없이 그가 거짓말하고 있다고 판정할 수도 없다.
완료 점검
한 화의 콘티를 다 쓴 뒤, 항목별로 대조한다:
- 두 사람의 얼굴을 가리고 실루엣만 보고, 누가 누구인지 말할 수 있는가.
- 이름과 호칭을 전부 지우고 동작만 남겼을 때, 대사가 여전히 지목 가능한가.
- 동작 지시를 전부 지우고 호칭만 남겼을 때, 여전히 지목 가능한가.
- 중경 하나를 골라, 소지품 위치가 식별표와 일치하는지 확인한다.
- 네 가지 단서가 하나도 등장하지 않는 단락이 있는지 확인한다——있다면 한 가지를 보충하고, 얼굴형이 혼자 감당하게 두지 마라.
다섯 가지를 모두 통과해야 이번 식별 점검이 완료된 것이다. 어느 하나라도 통과하지 못하면 먼저 빠진 단서를 보충하고, 보충한 뒤 다섯 가지를 전부 다시 대조한다. 동작 하나를 추가한 것을 효과가 이미 검증된 것으로 여기지 마라.
AI 출력이 관련될 때의 한 가지 제한
대사나 콘티를 AI가 생성한다면, 프롬프트에 네 가지 단서를 적어도 매번 맞는다고 보장할 수 없다; 생성 결과는 위 점검에 따라 사람이 항목별로 대조해야 하며, 특히 소지품 위치와 동작 귀속은 모델이 두 사람의 습관을 혼용하기 쉽다.
바로 할 수 있는 한 가지
지금 있는 닮은 캐릭터 한 쌍을 가져다가 위와 같은 네 줄 식별표를 채우고, 기존 대사 한 토막을 골라 이름을 지운 뒤 누가 말하는지 여전히 알아볼 수 있는지 보라. 알아볼 수 없다면, 단서가 아직 대사와 동작에 내려앉지 않았다는 뜻이다.